
Казахстанский журналист Марат Усманов однажды понял, что обычные сервисы транскрибации ему не подходят – записи бесед и интервью необходимо «заливать» на сторонние сервисы, что не очень безопасно с точки зрения конфиденциальности. Тогда он решил сделать локальную программу расшифровки текстов при помощи ИИ, которая будет «существовать» только на личном компьютере. Когда приложение было готово и показало хорошие результаты, аппетит, как говорится, пришел во время еды. Марат решил создавать международный сервис транскрибации с поддержкой нескольких языков. Его главная гордость – ИИ-модель, способная с высокой точностью распознавать казахский язык.
Пожалуй, для опытного программиста создание такого продукта не составило бы труда, но у Марата совершенно нет технического бэкграунда, и всю работу ему помогал выстраивать ИИ. О том, как журналист стал ИИ-разработчиком и вайб-кодером, редакции Er10.media рассказал создатель сервиса media2text.me Марат Усманов.
Расскажите, что за приложение вы создали?
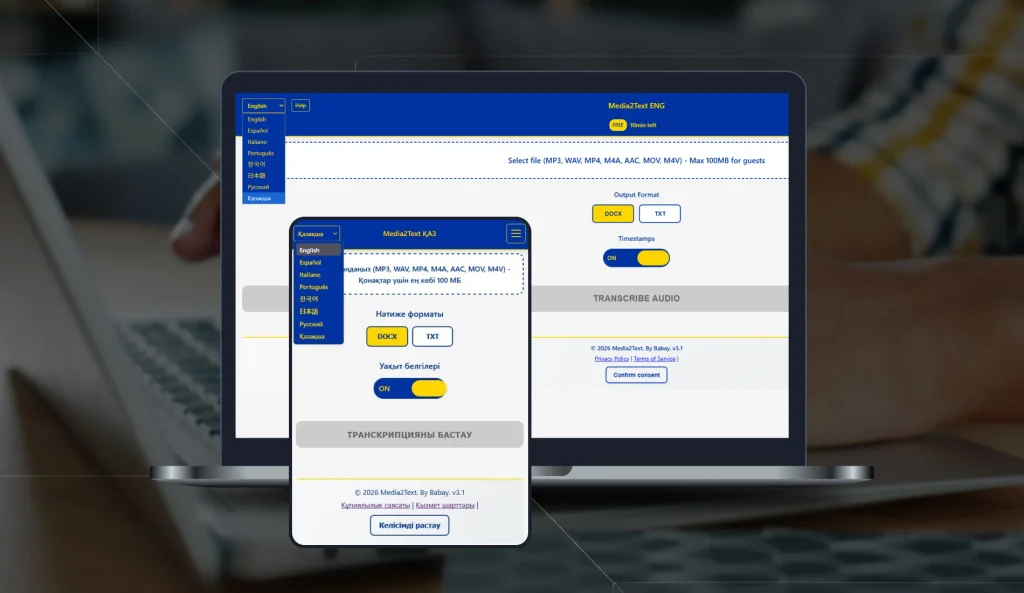
– Это программа по извлечению текстов из медиафайлов. Берете аудио или видео с речью, чьим-то выступлением, лекцию, совещание, можно даже песню какую-то, загоняете в приложение, и искусственный интеллект извлекает из вашего файла содержащийся там текст и выдает вам. Можно пользоваться с компьютера и ноутбука, а также есть приложение для android.
– Как пришла идея создать приложение для транскрибации? Ведь на рынке их достаточно много.
– Любой журналист знает, что такое расшифровка записанного материала. Это отнимающая время, нудная, но важная работа. Порой ты не торопишься, или, другой раз твой топик с актуальной цитатой спикера ждут еще вчера, но в любом случае расшифровка это неотъемлемая часть процесса.
Несколько раз, когда время поджимало, я обращался к сетевым сервисам, как правило на базе браузеров, ни один из них мне не зашел мне настолько, чтобы запомнить, положить в закладки, возвращаться туда снова.
Еще один минус использования сторонних сервисов – это отсутствие понимания, что их владельцы делают с моими медиафайлами и результатами расшифровок после завершения работы.
Я к тому, что и спикеры бывают разные, порой могут сказать лишнего, и не каждый источник информации готов давать комментарии открыто. Да мало ли какие бывают ситуации, а мне нужна гарантия защиты моих и пользовательских данных.
Однажды, когда вновь припекло, я просто загуглил как вообще производится автоматическая транскрибация.
Оказалось, что ИИ-моделей, которые занимаются именно распознаванием речи, их, ну всего пара десятков высокого уровня, плюс еще пара тысяч поменьше. Я прикинул, поискал, выбрал что мне нужно и скачал.
Это не юзер-френдли продукты, типа приложений из коробки, типа кликнул разок, подождал пока распакуется, и пользуйся. Там все немного сложнее, но и не бином ньютона – разобраться по силам.
На коленке я собрал, конечно, при помощи ИИ простейшую оболочку под ту модель – никакого интерфейса, очень примитивно, перетаскиванием файлов мышкой, но все заработало.
Качество распознавания русского языка у выбранной мной модели было процентов 90 с небольшим, и мне хватало. Интернет не нужен – все на домашнем компе, плюс, что очень важно, нет риска утечки информации, как в публичных сервисах. Так что вопрос с личными нуждами в транскрипции был снят.
– То есть, началось все с проекта лично для себя? А потом вы решили, что такой продукт может быть востребован на рынке?
– Ну, да, фактически. Там как в том анекдоте, чем дальше в лес, тем толще партизаны. Работа дома стала много проще: закинул, подождал, вытащил, подчистил. А вот при выездах в поля, на всякие брифинги и встречи, там ничего такого под рукой не было.
Где-то там я понял, что вполне смогу сделать что-то переносное, расшифровщик в кармане, может на флешке, или в телефоне. Потом пошли размышления, что делать, и как, мозговые штурмы с участием ИИ, разборы путей и вероятностей, и пошло-поехало.
Оно как-то закрутилось, и я отдавал проекту все свое внеурочное, не занятое на основной работе время. Забросил игры, сериалы, книги. Стал затворником фактически, но в итоге, через 3-4 месяца авральной работы я выдал на гора свой первый рабочий прототип.
Получилось рабочее и эффективно функционирующее приложение с понятным интуитивным интерфейсом, дообученным ИИ, качественной транскрипцией. Если бы у приложений были дни рождения, у моего продукта это было бы 22 октября 2025 года, когда я создал на github свой первый в жизни репозиторий и залил туда свой первый действующий продукт.
Потом был вывод стоявшего на домашнем компьютере приложения в сеть через туннель, первое публичное тестирование, сбор откликов. Затем последовал вполне логичный перенос с домашнего компа на сервер в Германии и через пару дней – полное катастрофическое обрушение. Приложение упало полностью.
– Что произошло?
– По сути, произошла моя некомпетентность, сказалось отсутствие фундаментальных знаний, элементарной подкованности практически по всем прикладным предметам, особенно в части того, как следует выстраивать архитектуру массового продукта.
Я тогда с неделю не мог прийти в себя, заставить себя вновь взяться за проект, начать двигаться дальше.
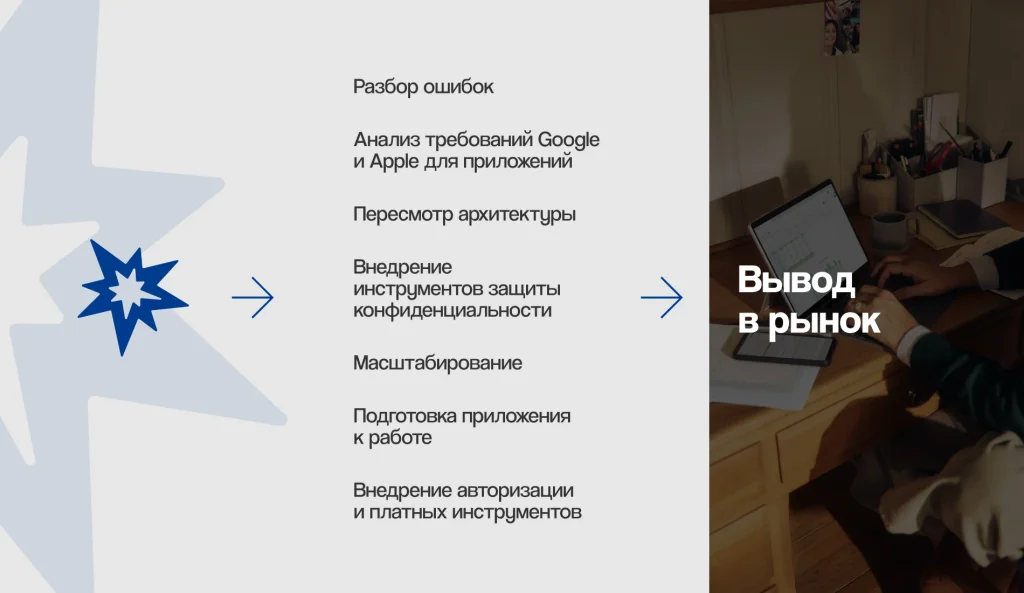
Но потом – разбор ошибок, анализ требований Google и Apple для приложений, пересмотр архитектуры, внедрение инструментов защиты конфиденциальности в соответствии с лучшим в этой сфере законодательством, масштабирование, подготовка приложения к работе с массой пользователей, внедрение авторизации и платных инструментов и, ну и вывод в рынок.
– А зачем нужны были требования Google и Apple?
– У этих платформ есть свои маркеты, огромные торговые площадки, и сотни миллионов устройств в их экосистемах по всей планете. Если брать вкупе, эти 2 корпорации держат и делят меж собой глобальный рынок мобильных приложений, и доступ туда строго через эти 2 хаба.
Любой автор, креативщик знает, что мало создать продукт. Съемка фильма, написание книги, песни – это всего полдела. Вторая половина дела это как вывести продукт на рынок, довести до потребителя, продать.
– Вы разместили свое приложение на сервере в Германии? В Казахстане не дешевле?
– Где на планете самое драконовское законодательство по защите конфиденциальности и прав пользователей? В Европейском Союзе.
Кроме того, тамошний регламент по защите данных GDPR – это глобальный образец, исторический первоисточник всех прочих аналогичных законов на планете.
Во-первых, я выстроил работу своего приложения, всех его сценариев работы с пользовательскими данными в соответствии с GDPR, сверял каждое изменение кода, каждое решение с законодательными нормами ЕС.
Во-вторых, владельцы расположенных в Германии серверов также следуют букве европейского закона и обеспечивают защиту конфиденциальных данных по тем же самым законодательным нормам.
И еще один очень важный момент, соответствие цена-качество. У немцев оно на высоте. Я, к слову, мониторил отечественные сервисы, изначально хотел арендовать сервер, не «отходя от кассы», но аналогичные нужным мне серверные услуги в Казахстане стоят значительно дороже.
– И что в итоге?
– Я продолжаю развивать свой продукт, ну и попутные проекты. Недавно я выпустил большой апгрейд своего приложения – вложил под капот две мощных модели искусственного интеллекта вместо одной, как было изначально. Причем одну из моделей я дообучал казахскому языку сам, и, в целом, благодаря этому апгрейду мое приложение теперь способно извлекать из медиафайлов казахскую речь. Там доступны еще 7 языков: английский, русский, японский, португальский, корейский, испанский и итальянский.
– Вы вывели на международный рынок приложение с ИИ, который распознает казахский язык на слух. И что, обученный вами ИИ реально понимает казахский язык?
– Попробуйте сами. Приложение в свободном доступе в Google Play – media2text.me by Babay. Я сейчас свожу полученные в ходе обучения данные в статью, в отчет, хочу рассказать, как проходило обучение, какие методы использовались и чего, какого уровня удалось добиться. Кстати, у модели еще есть потенциал, я мог бы продолжить обучение, но пришлось остановиться. Проблема в учебниках, их не хватает.
– То есть?
– Очень мало данных для обучения ИИ казахскому языку. Наборы данных можно по пальцам одной руки пересчитать, общий объем всех учебников менее 2 тысяч часов, это капля в море.
Кроме того, лишь незначительная часть этих наборов содержит разносторонние данные для обучения – диалекты, региональные выговоры и прочие нюансы.
Правды ради, в начале октября презентовали якобы прорывной проект, датасет-учебник на 12 тысяч часов, но я покопался при помощи ИИ – его нет в публичном доступе, то есть он корпоративный, закрытый, и таким как я, в смысле, индивидуальным стартаперам, от него пользы ровно ноль.
К слову, пару месяцев назад я задавал вопрос одному из профильных вице-министров, почему так? Почему в стране, где на цифровизацию и развитие ИИ выделяются триллионы тенге, не хватает прикладных датасетов для обучения ИИ казахскому языку? Тот признал проблему, и публично заявил, что МИИЦР РК приветствует помощь в этом направлении.
– Получается, вы дообучили чужую модель ИИ лучшему пониманию казахского языка? Наверное для этого нужны серьезные вычислительные ресурсы?
– У меня обычный домашний комп, старенький уже – десятое поколение, 32 оперативки, 12 видеопамяти. Этого хватает для обучения, правда, кроме обучения в ходе процесса ничего там больше делать не получиться, разве что текст написать, это максимум. Все ресурсы уходят на процесс, дни, недели. Потом анализ результатов, работа над ошибками, смена угла обучения, и запуск новой сессии.
– И что дальше?
– Планов громадье. Идей море. Времени не хватает. И ситуация меняется так быстро, что порой не поспеваешь. Но, в интересное время живем. Может даже слишком интересное.